一、问题,从一位总监的问话说起
今年三月,一家女装品牌的供应链总监找上门,张口就问:“金波老师,能不能算出来,这个款下个月要备多少布?”他们刚上了一套带预测功能的系统,销售模块跑得还行,他想顺手把面料备货也扔进去。金波老师说能算,但算出来你不敢用。他不信。于是我们前后试了两个月。这篇文章不讲AI多神,讲的是它预测面料的边界在哪,以及在这条边界之内,小厂怎么用得起来。
二、第一次尝试:喂三年数据,算单款
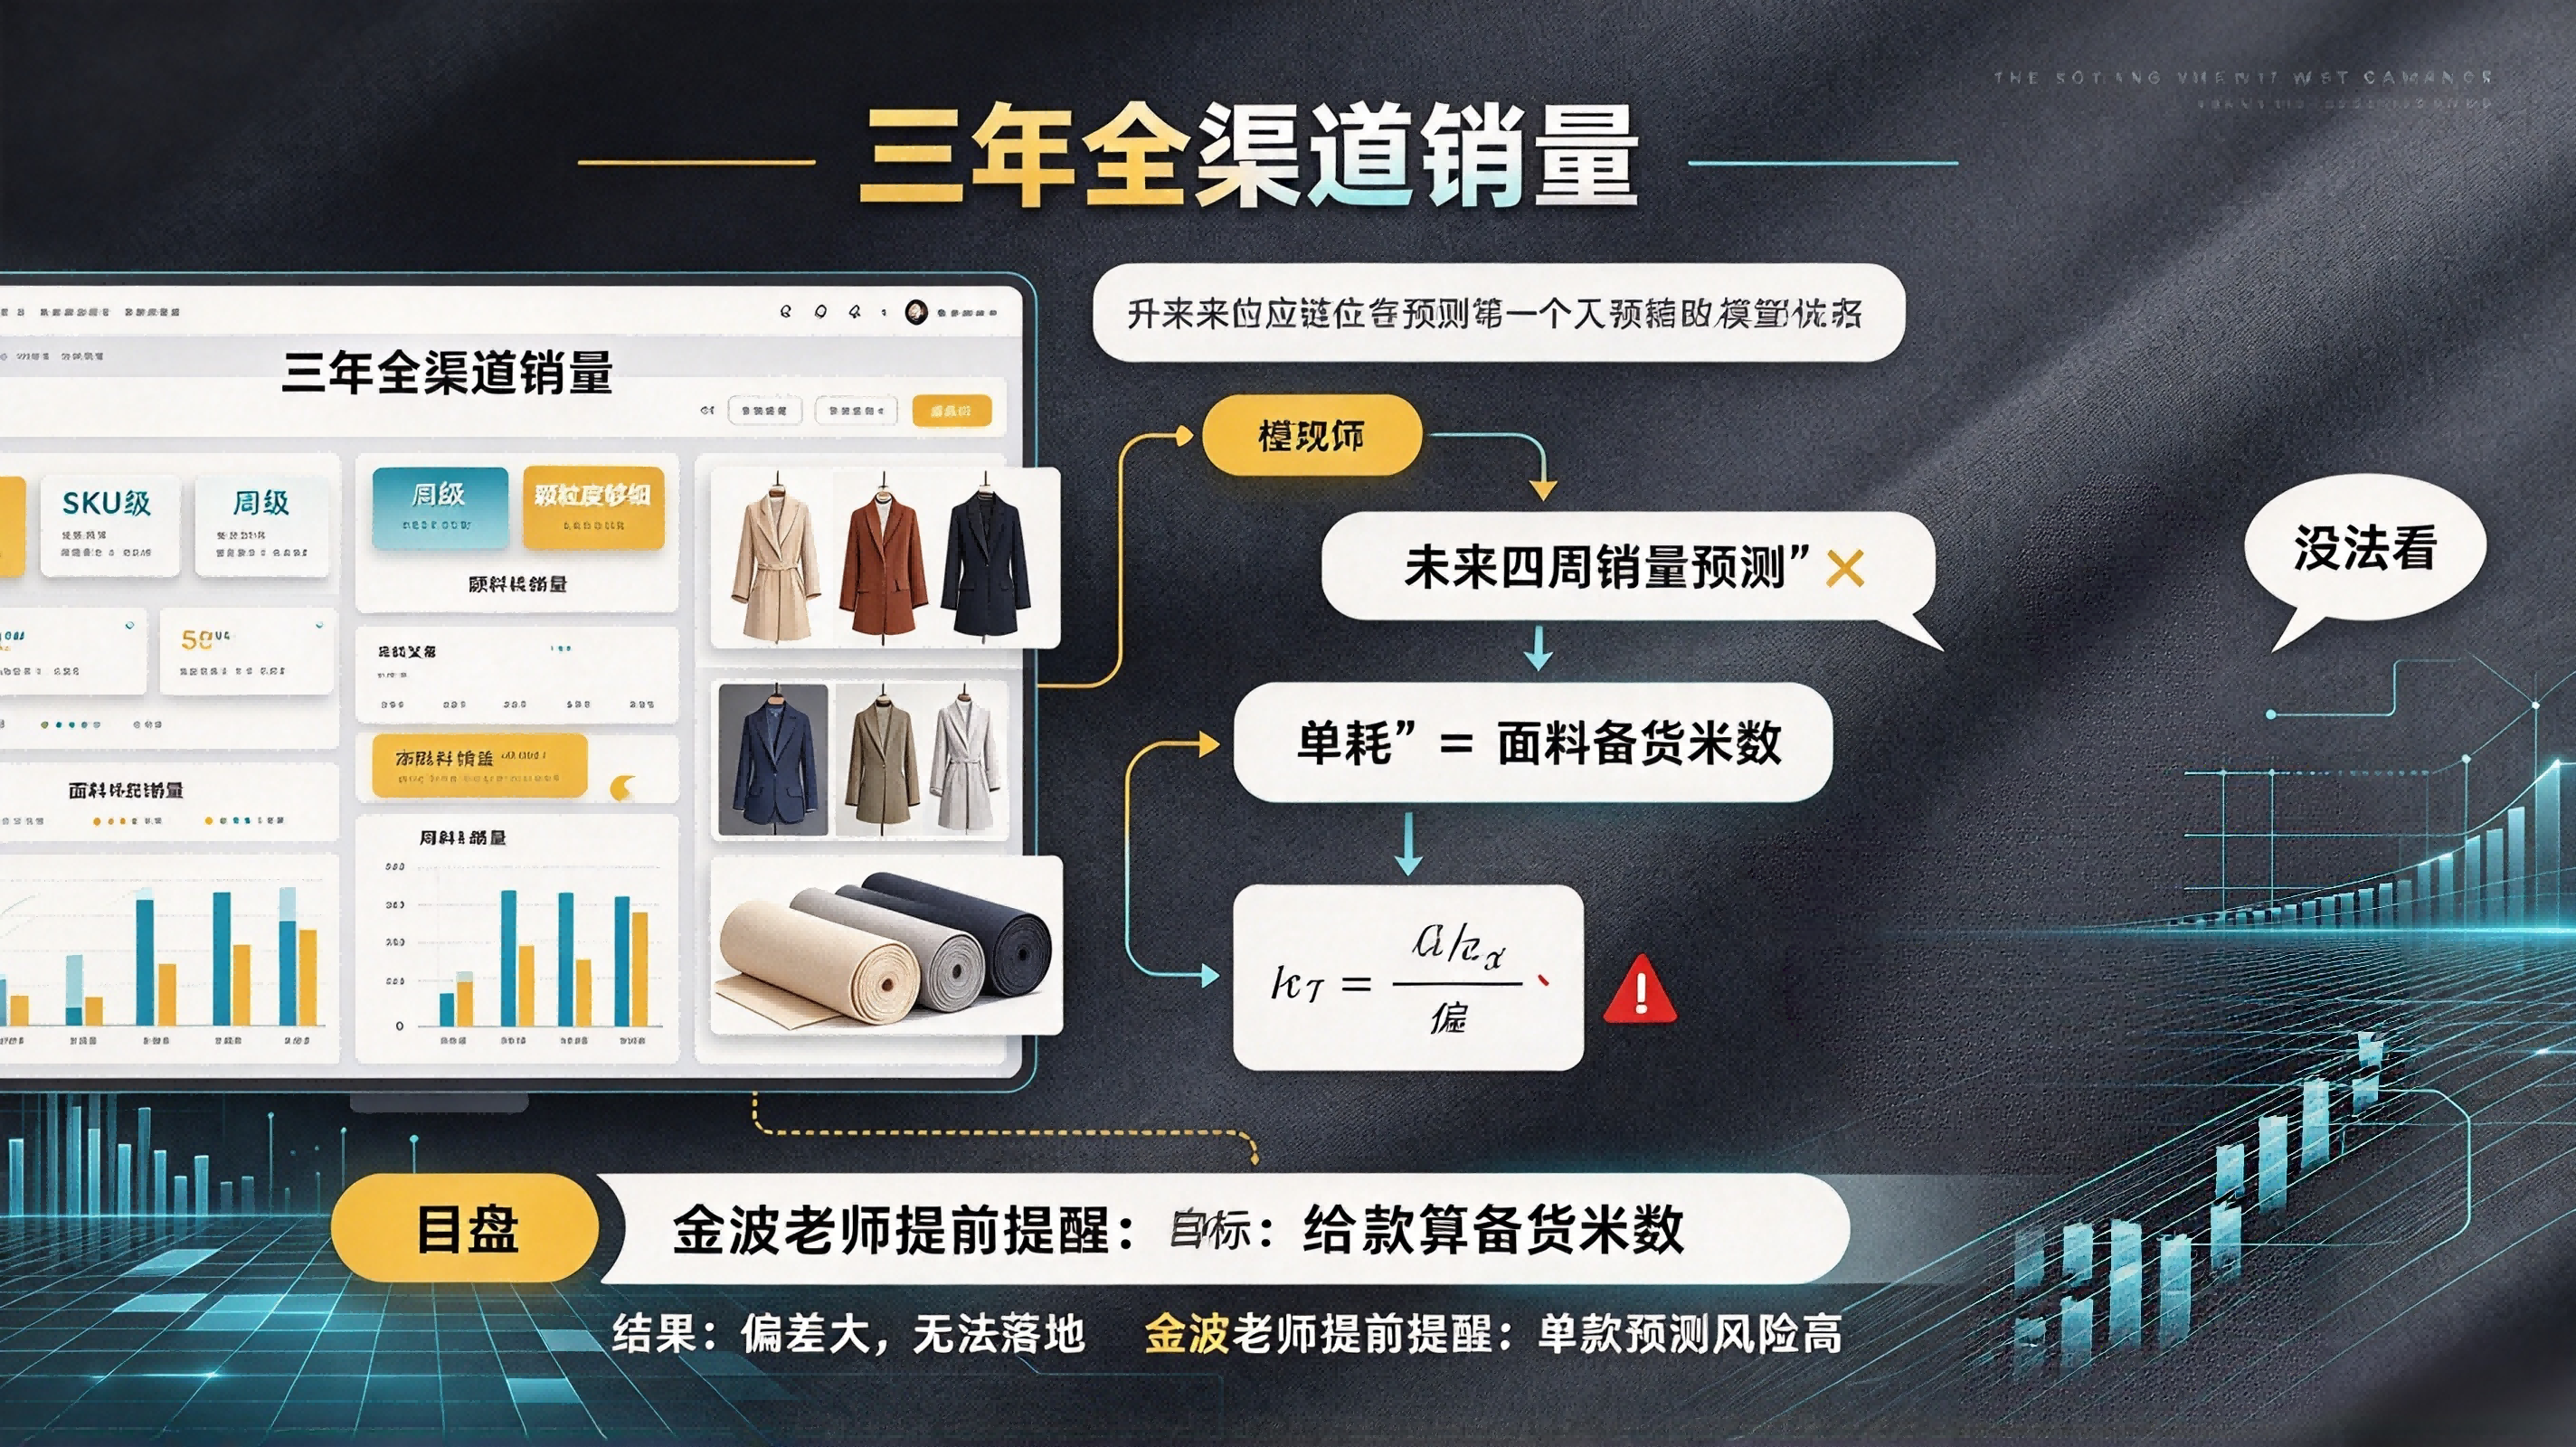
他们的数据底子不错,三年全渠道销量都在系统里,SKU级、周级,颗粒度够细。第一版模型的目标很直接:给每个款预测未来四周销量,乘以单耗,得出这个款要备多少米布。跑出来的结果,用总监的话说,就是“没法看”三个字。他不信金波老师提前说过的话,这一回,算是亲自尝了滋味。
三、回测三十个款:平均偏差38%
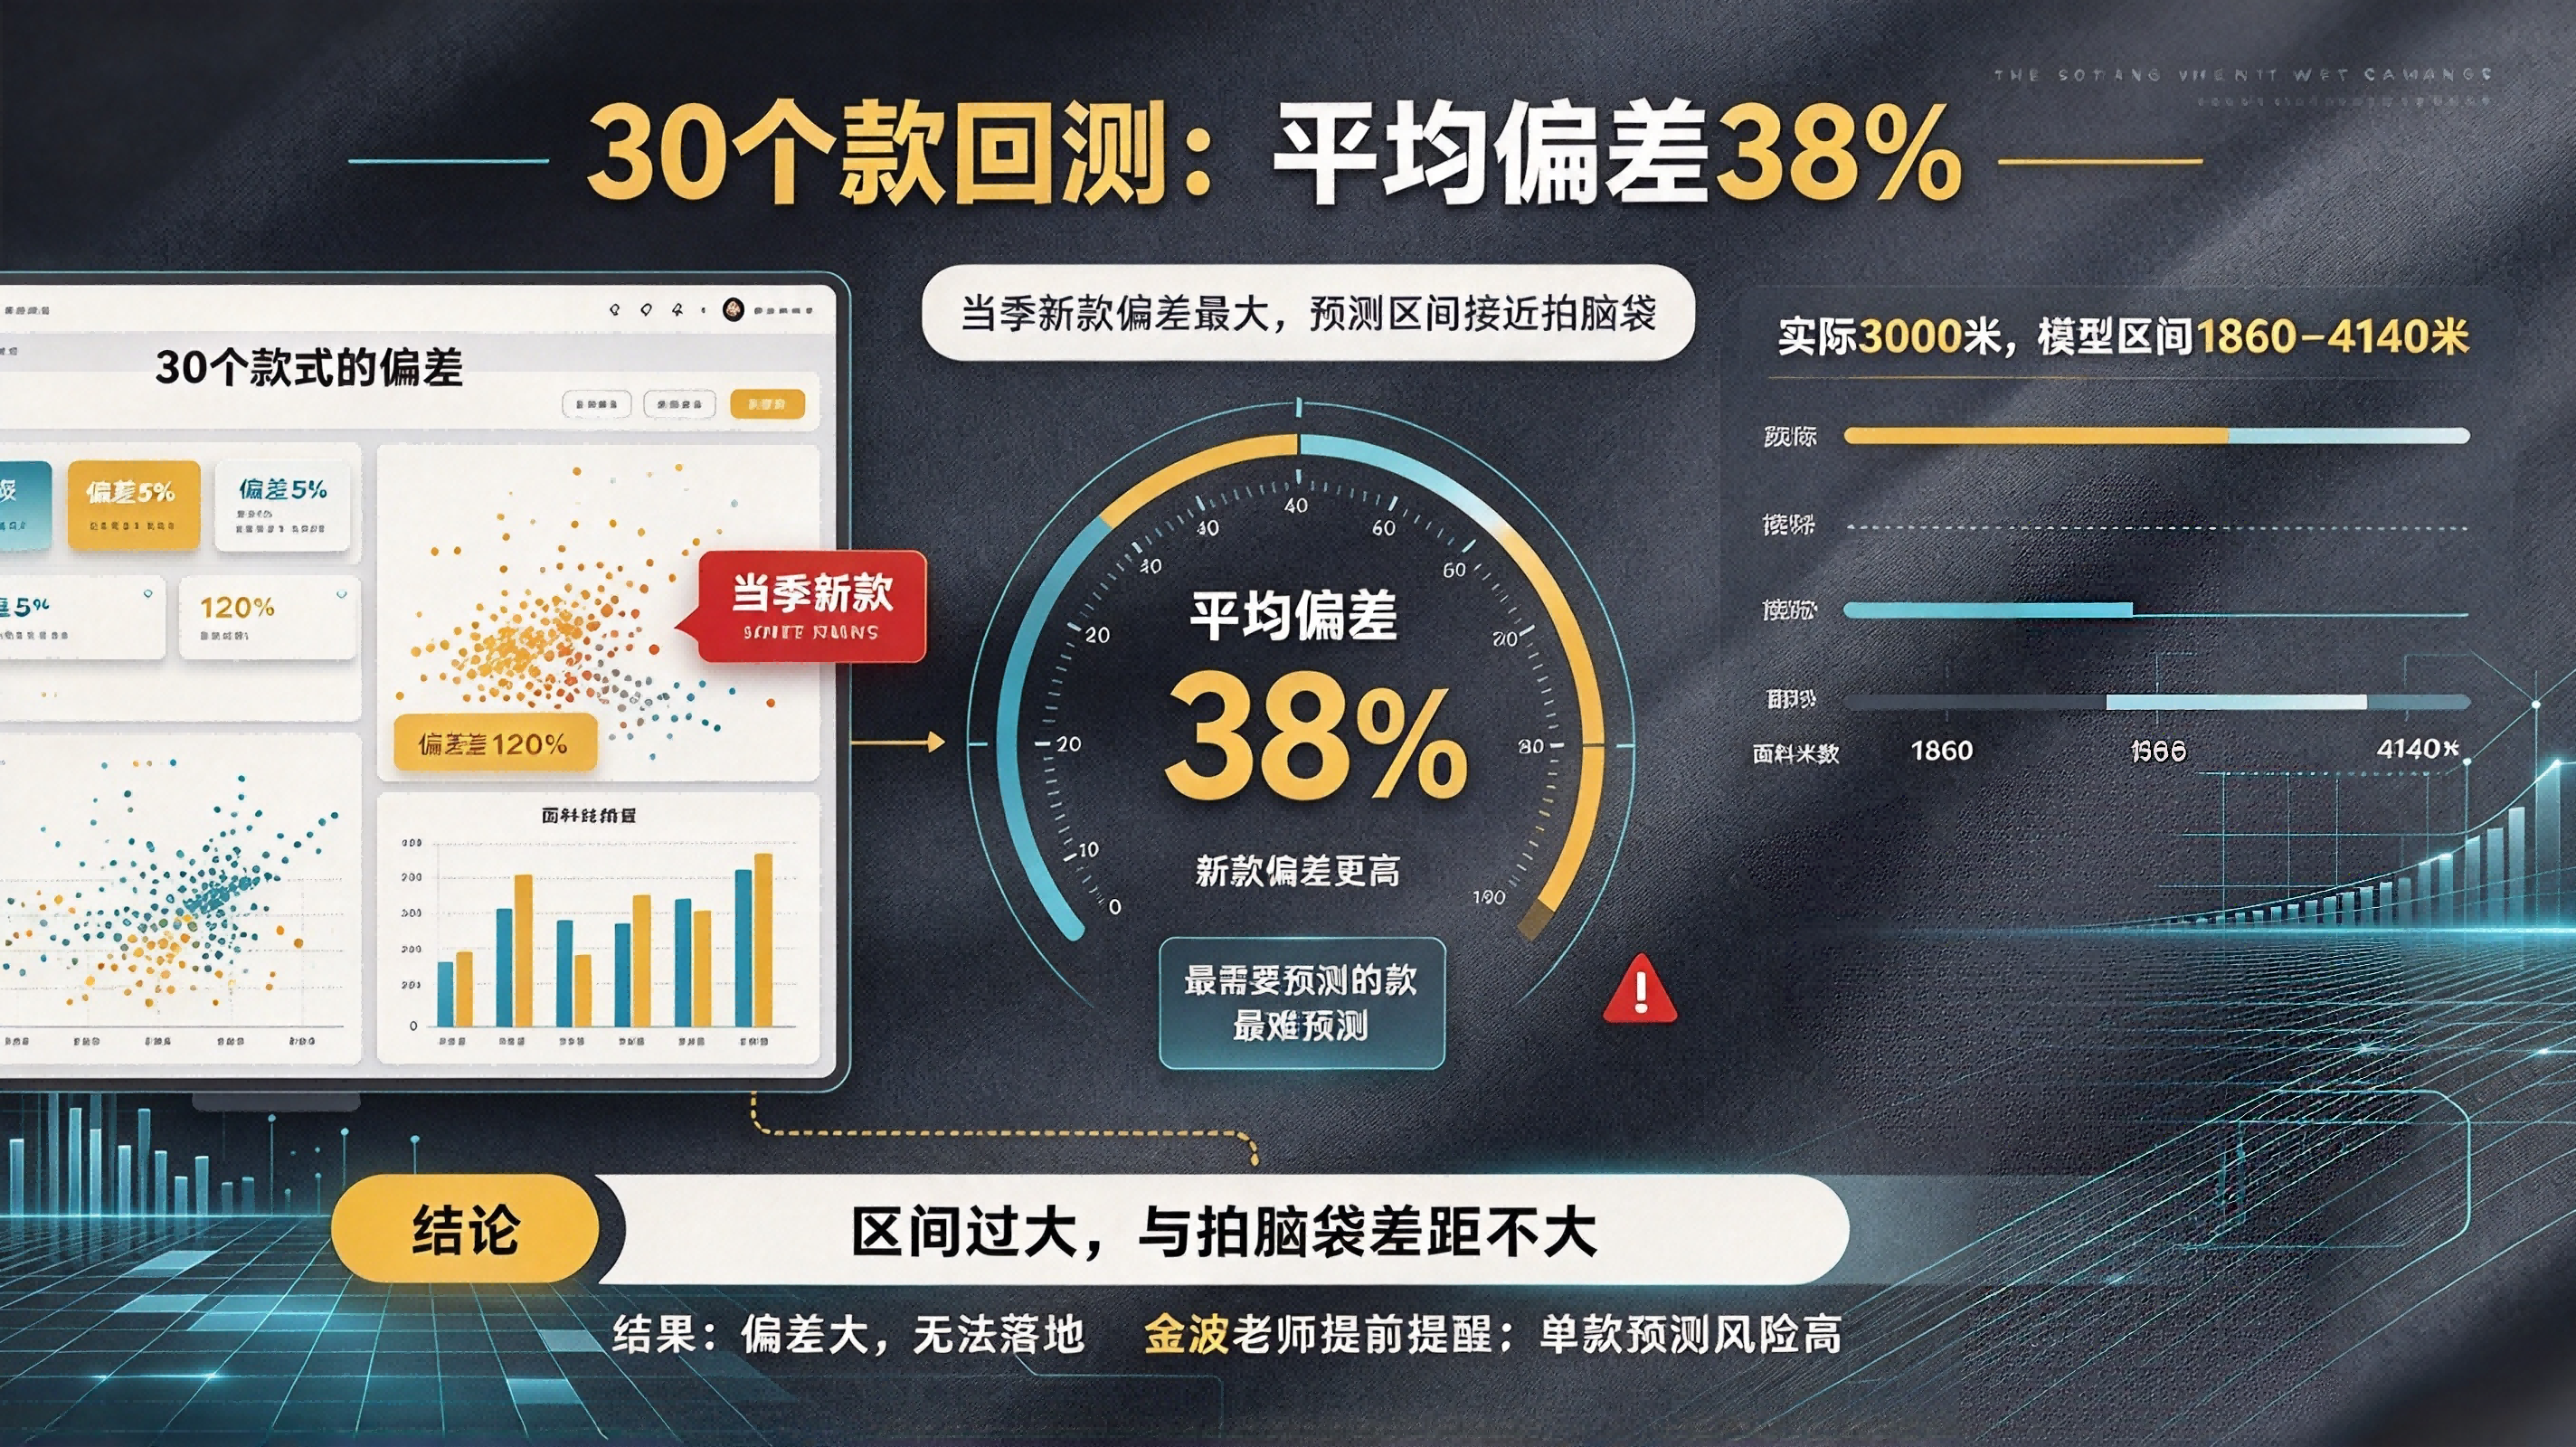
我们抽了三十个款回测,预测值和实际值的平均偏差是38%。有的款偏差5%,有的款偏差120%。偏差大的,全是当季新上的款,恰恰是最需要预测的那批。38%意味着什么?如果实际要三千米布,模型给出的区间是1860到4140米,跟拍脑袋的差距,其实不算大。
四、病根不在算法,在样本
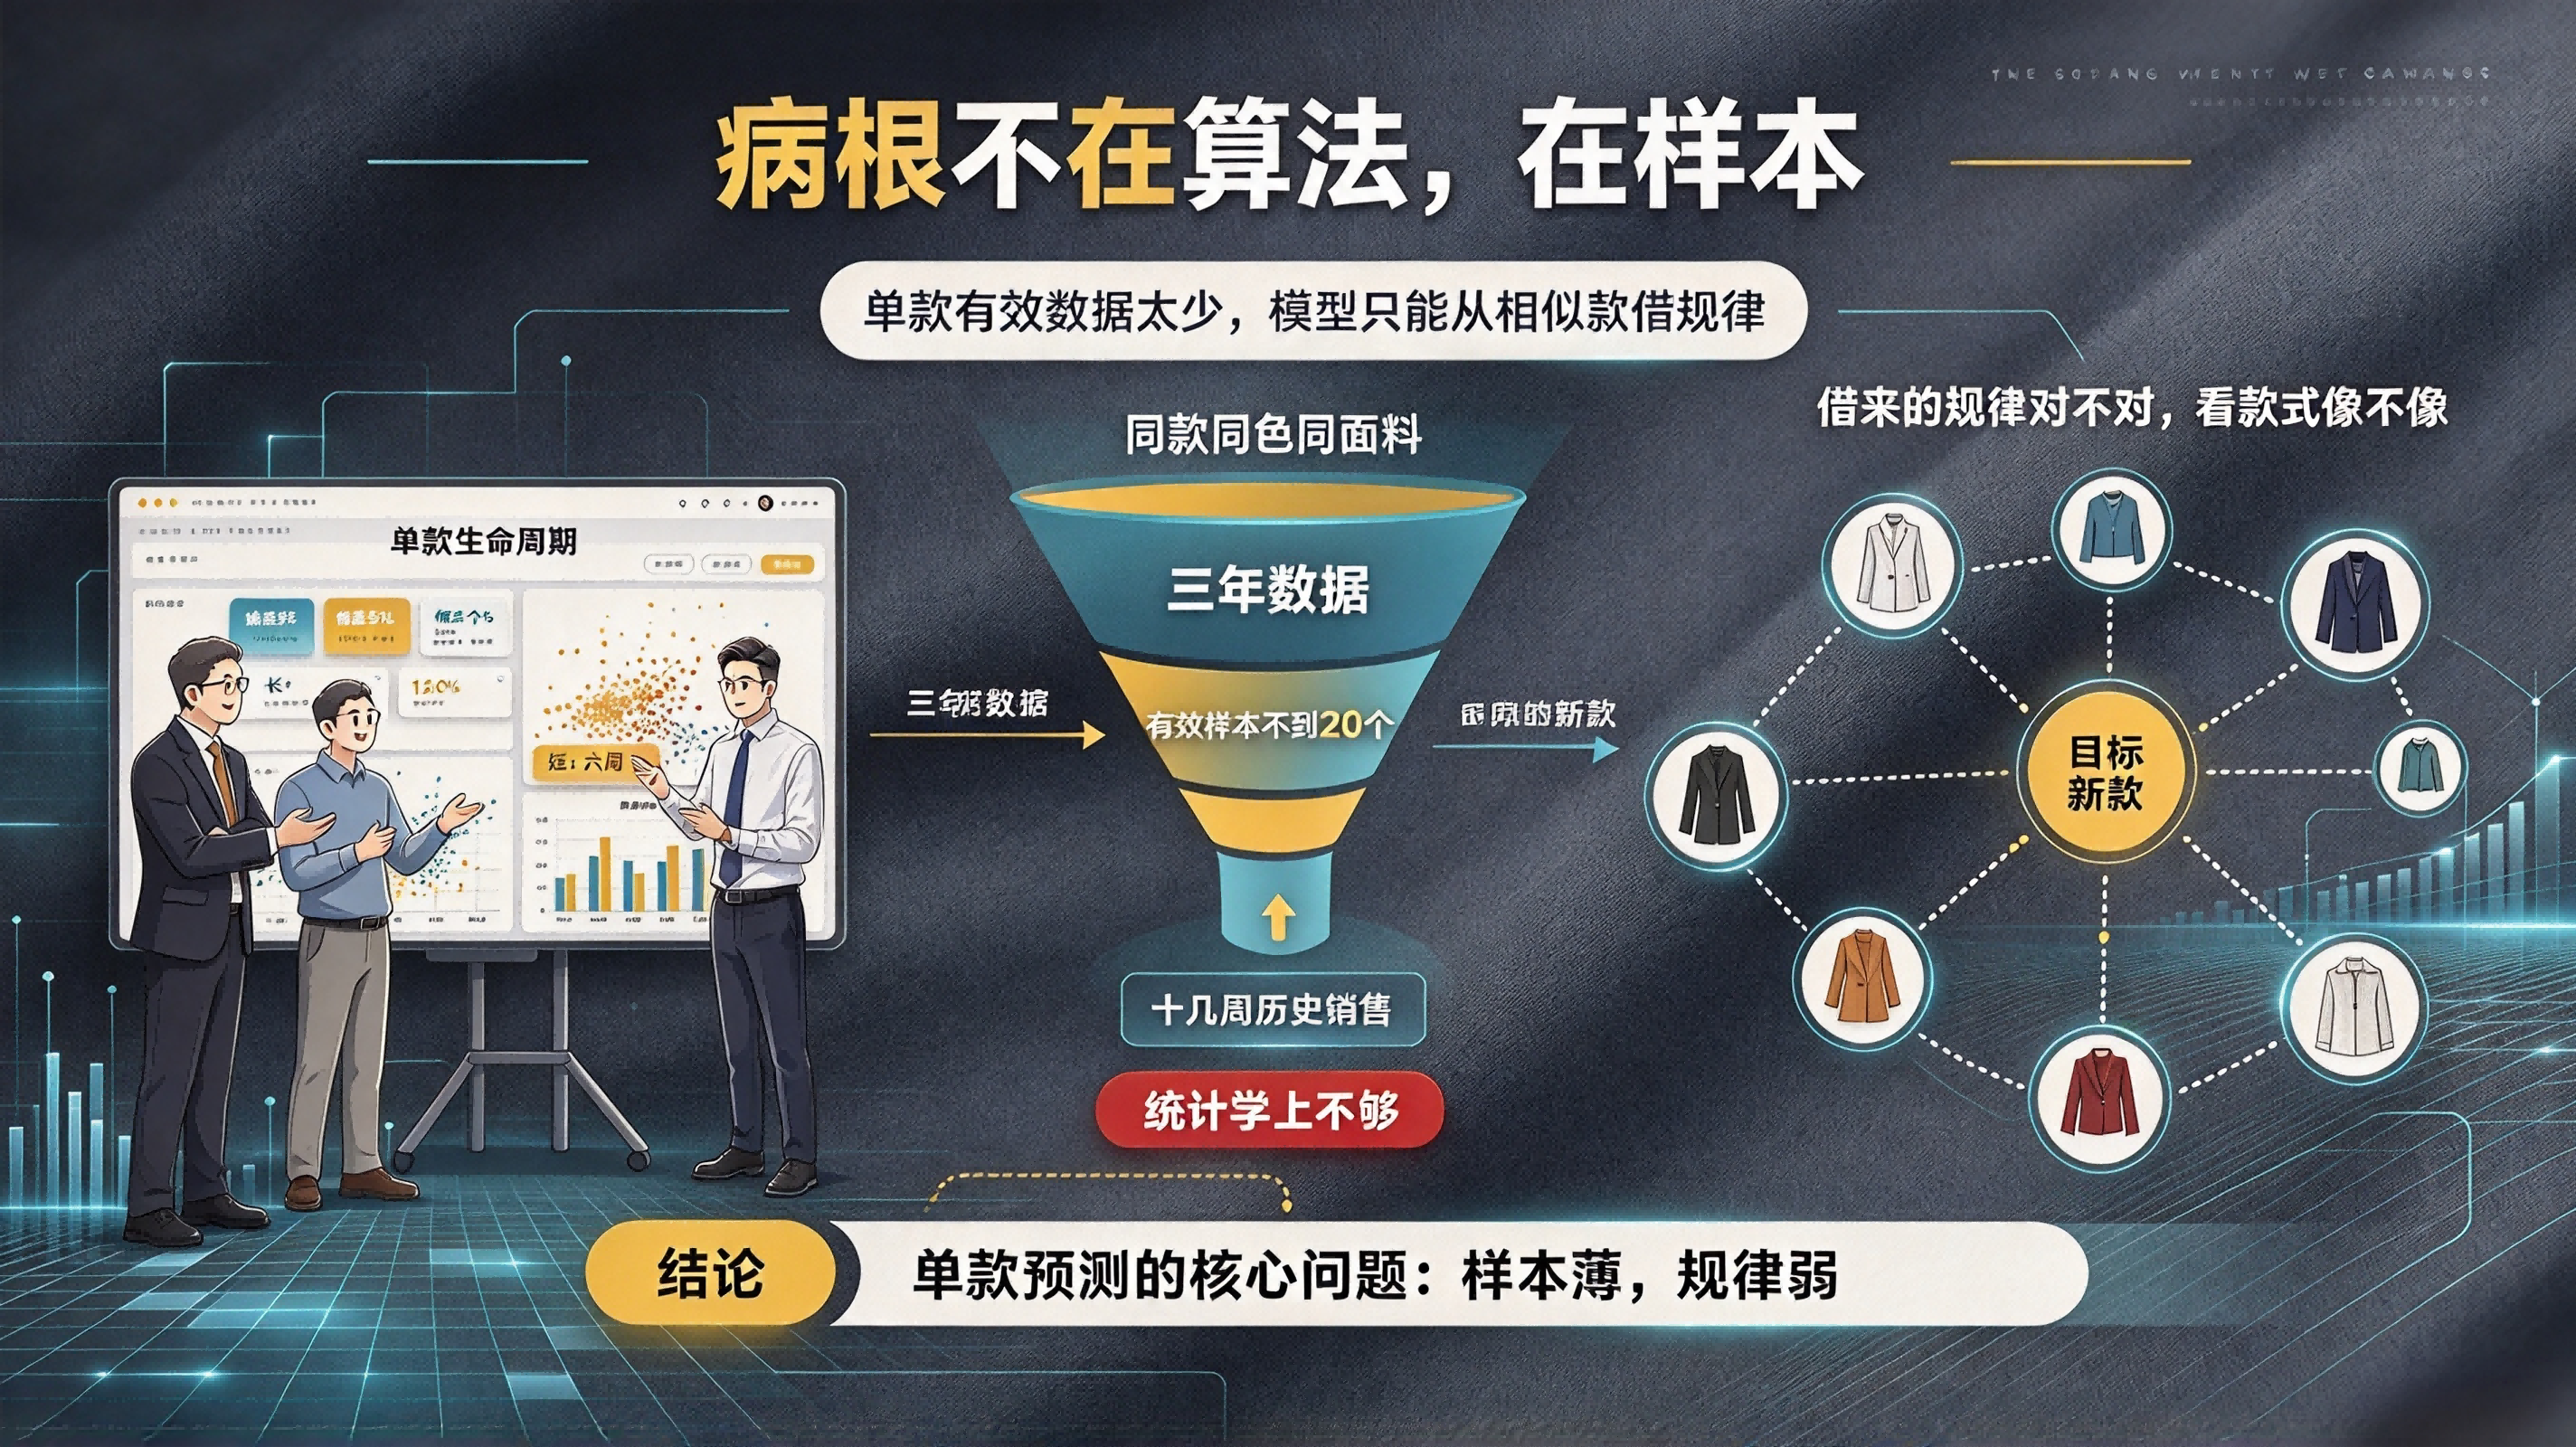
后来金波老师跟做模型的工程师聊了很久,最后把问题归结到两件事。第一件,单款是小样本。一个款的生命周期,长的一个季,短的六周。三年数据听着多,拆到“这一个款”,有效样本往往不到二十个:同款同色同面料的历史销售周,可能就十几周。十几个样本点要预测一个新款,统计学上就是不够。模型只能从别的款身上借规律,借来的对不对,全看两个款像不像。
五、平台的玩法,说变就变
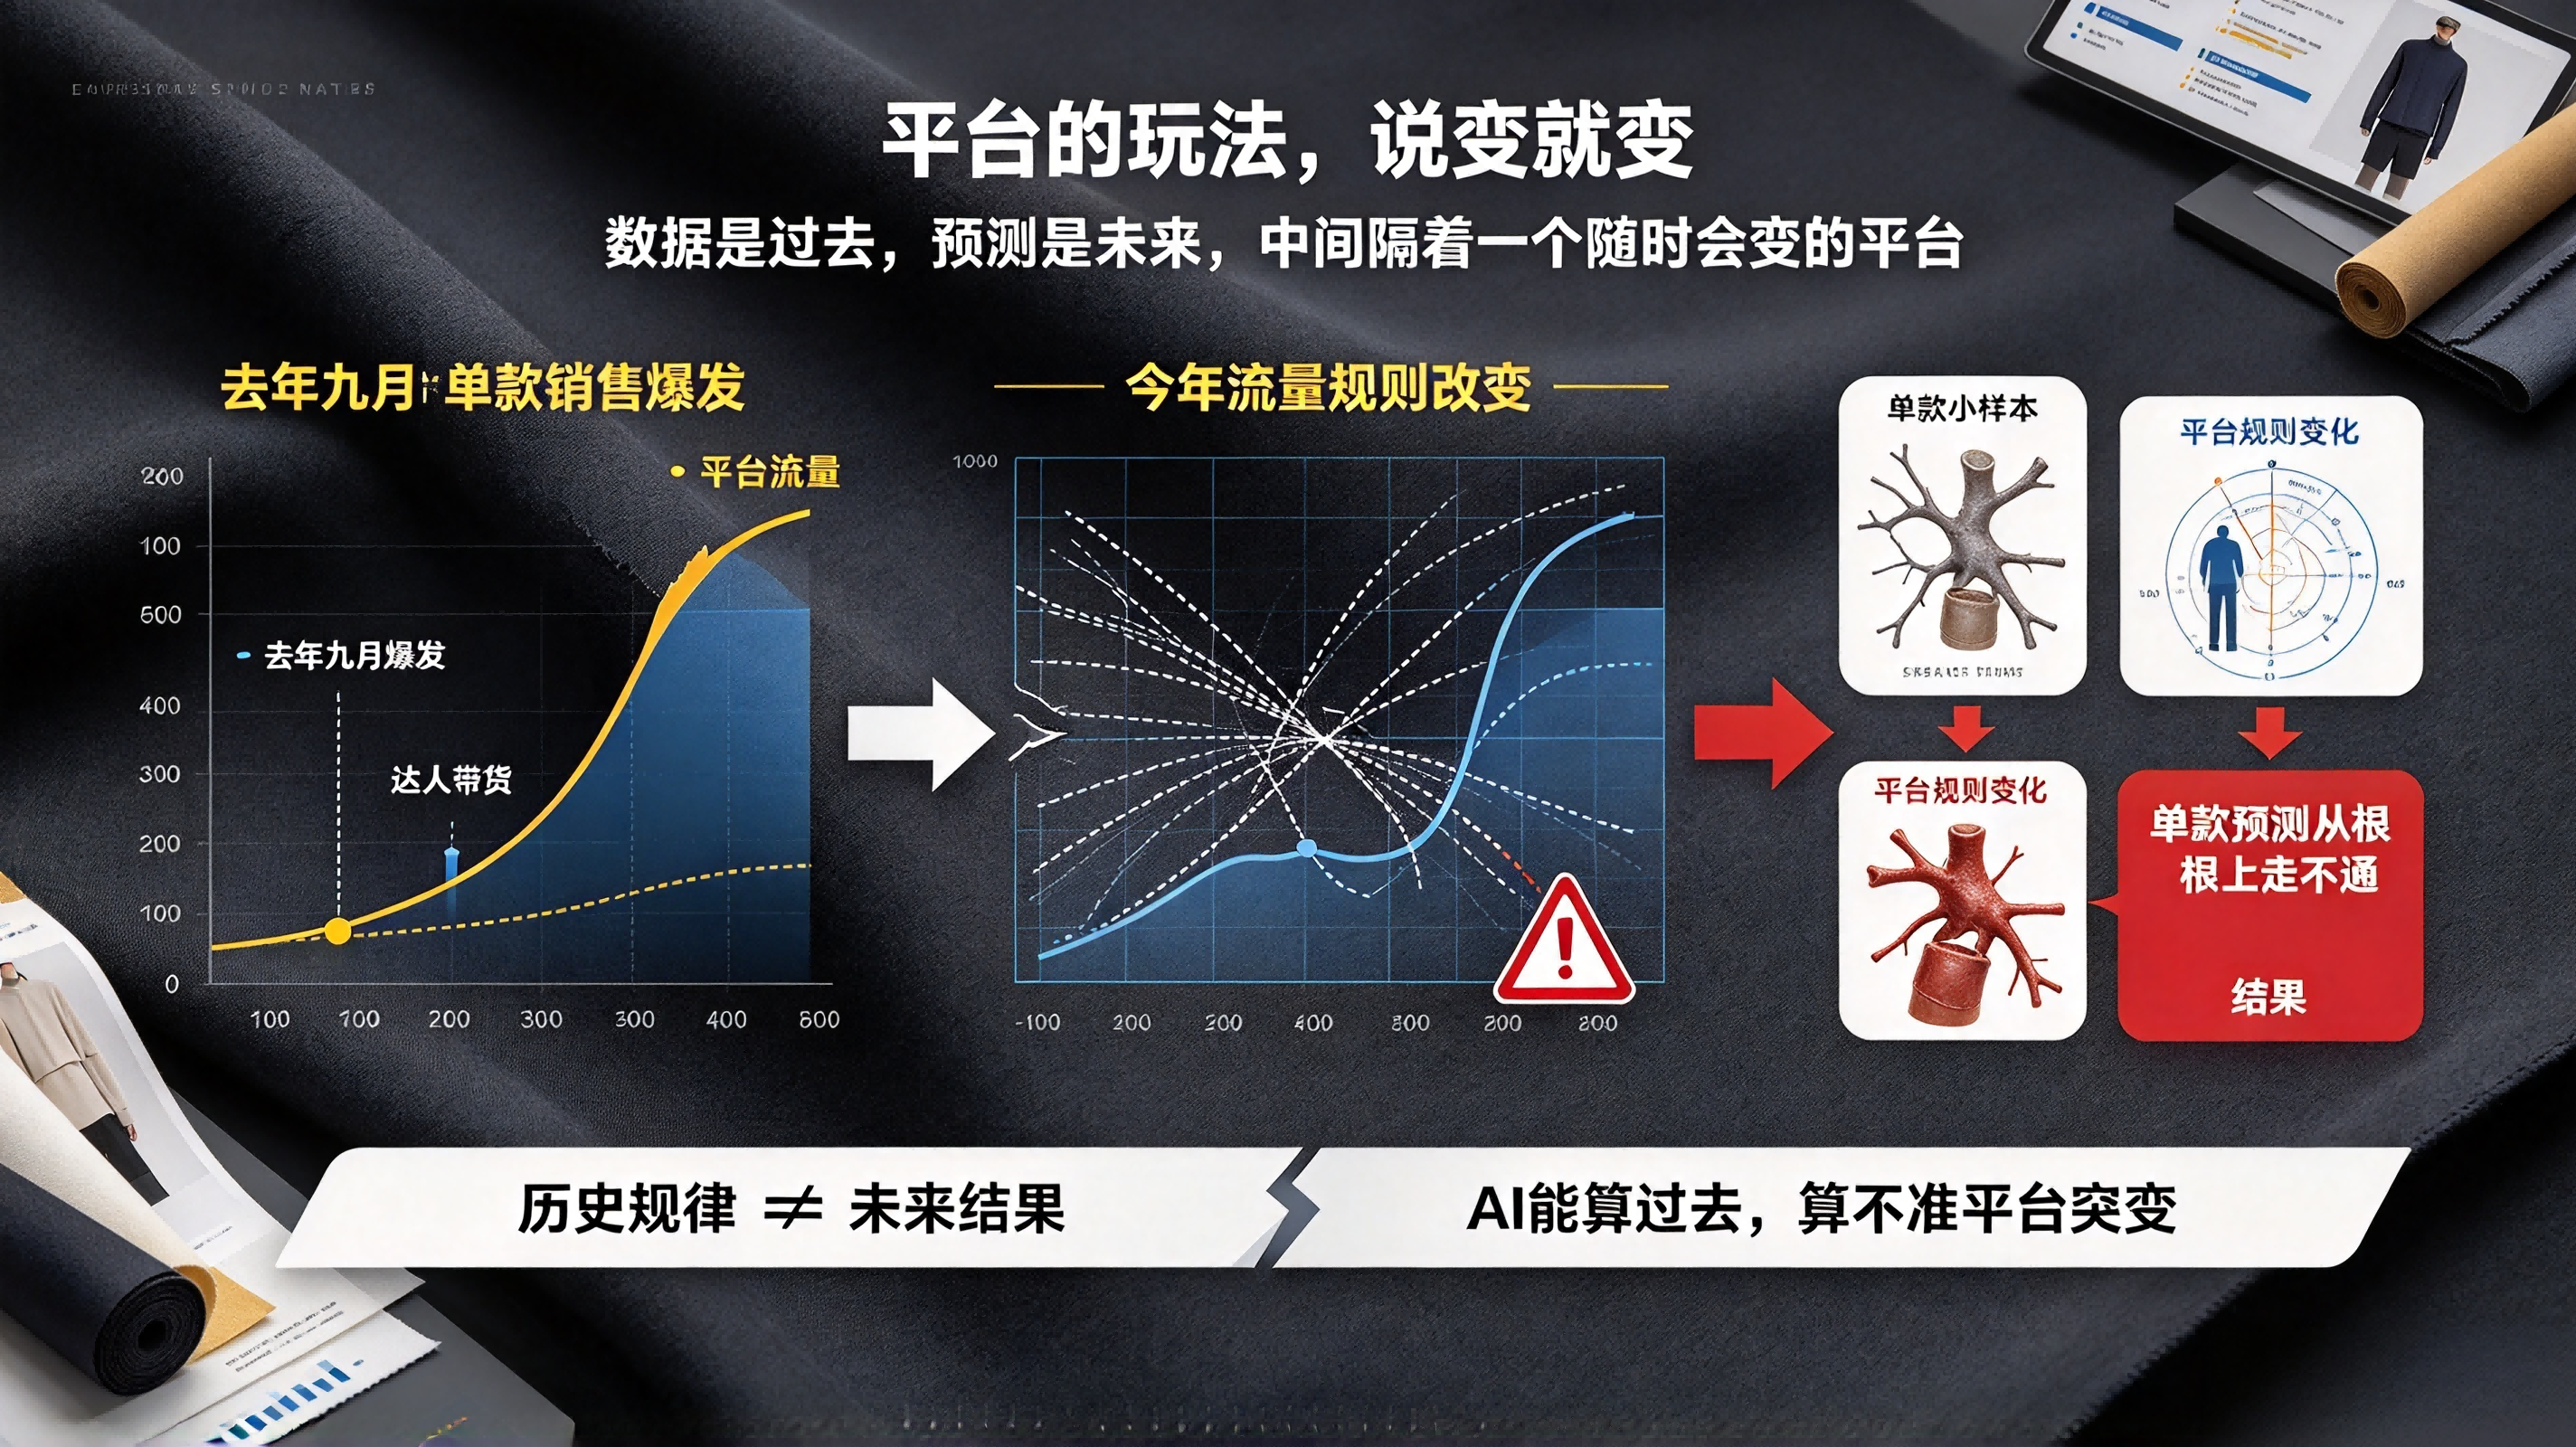
第二件,平台的玩法会变。去年某个款在九月爆发,可能是平台给了一波流量,也可能是某个达人带了一轮。今年的流量规则改了,历史规律直接失效。数据是过去的事,预测是未来的事,中间隔着一个随时会变的平台。这两个病根加在一起,单款预测这条路,从根上就走不通。
六、第二次调整:不算“点”,算“带”
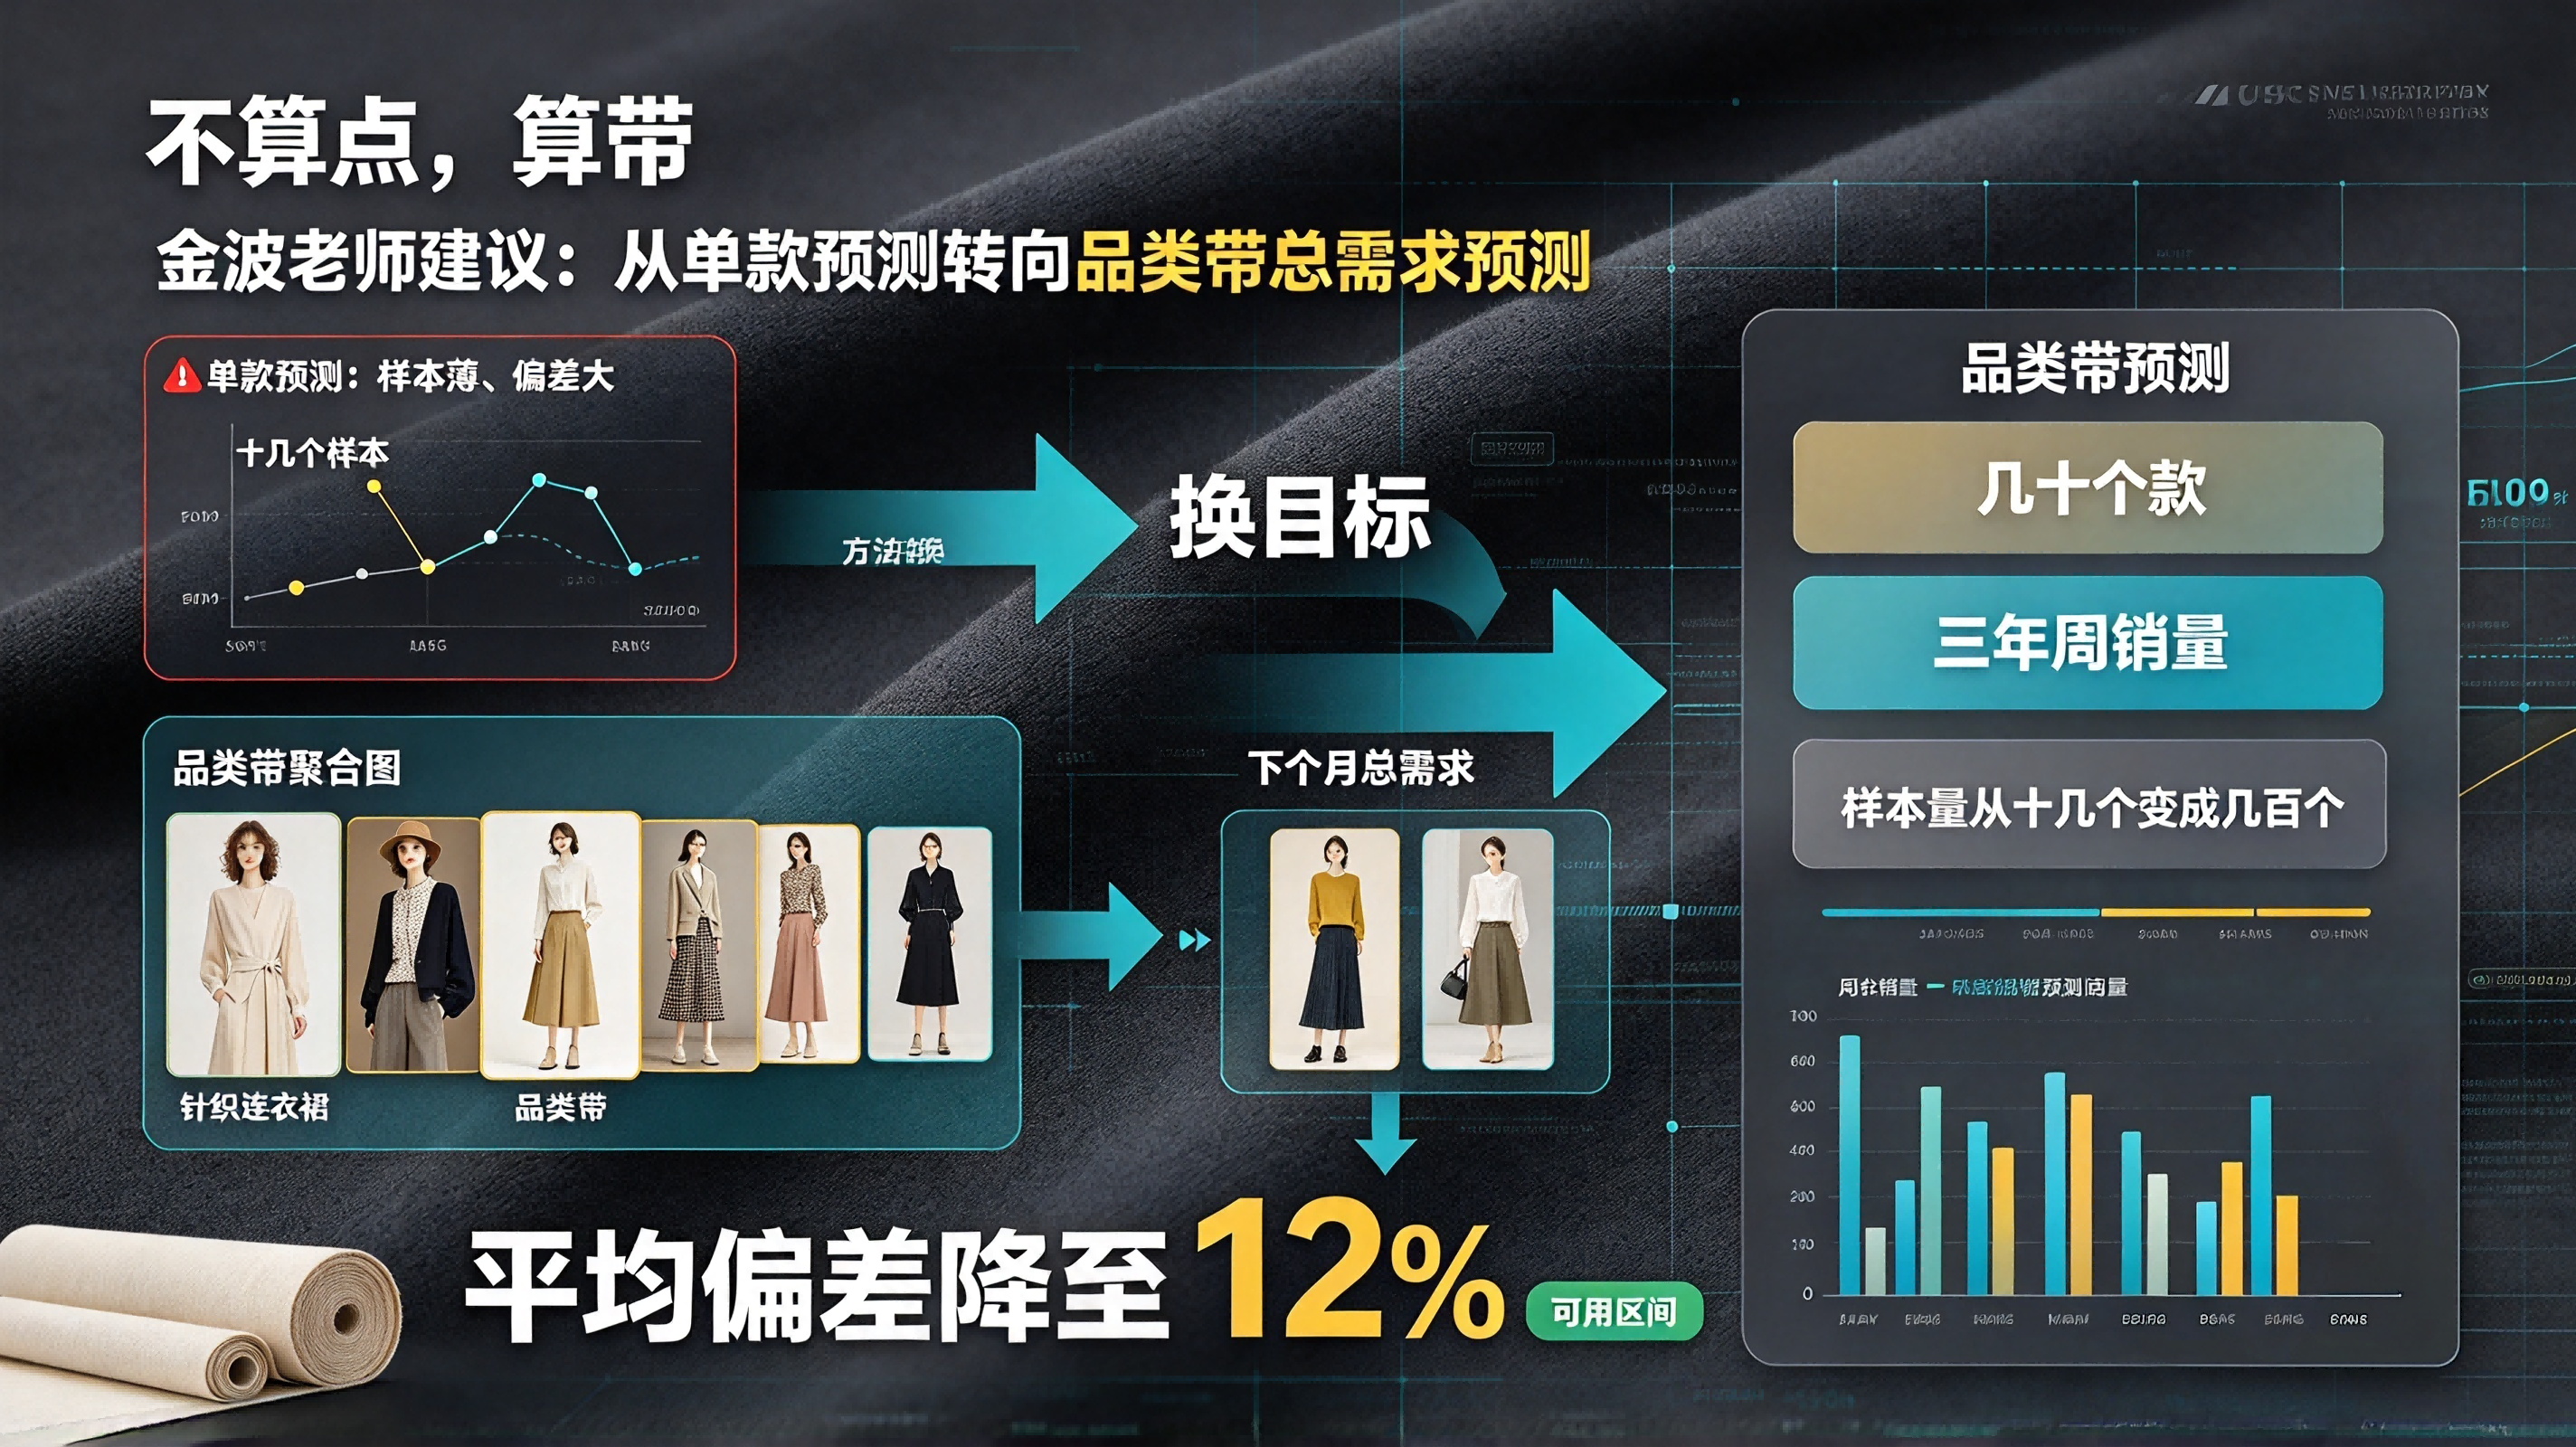
既然单款算不准,金波老师建议换个目标:不预测“这个款要多少布”,改成预测“这个品类带下个月要多少布”。比如把所有针织连衣裙归成一个带,预测整个带下个月的总量。带里的样本一下就厚了:几十个款、三年的周销量,样本量从十几个变成几百个。回测这个版本,预测值和实际的平均偏差,降到了12%。
七、有了这个数,备货策略也跟着变了
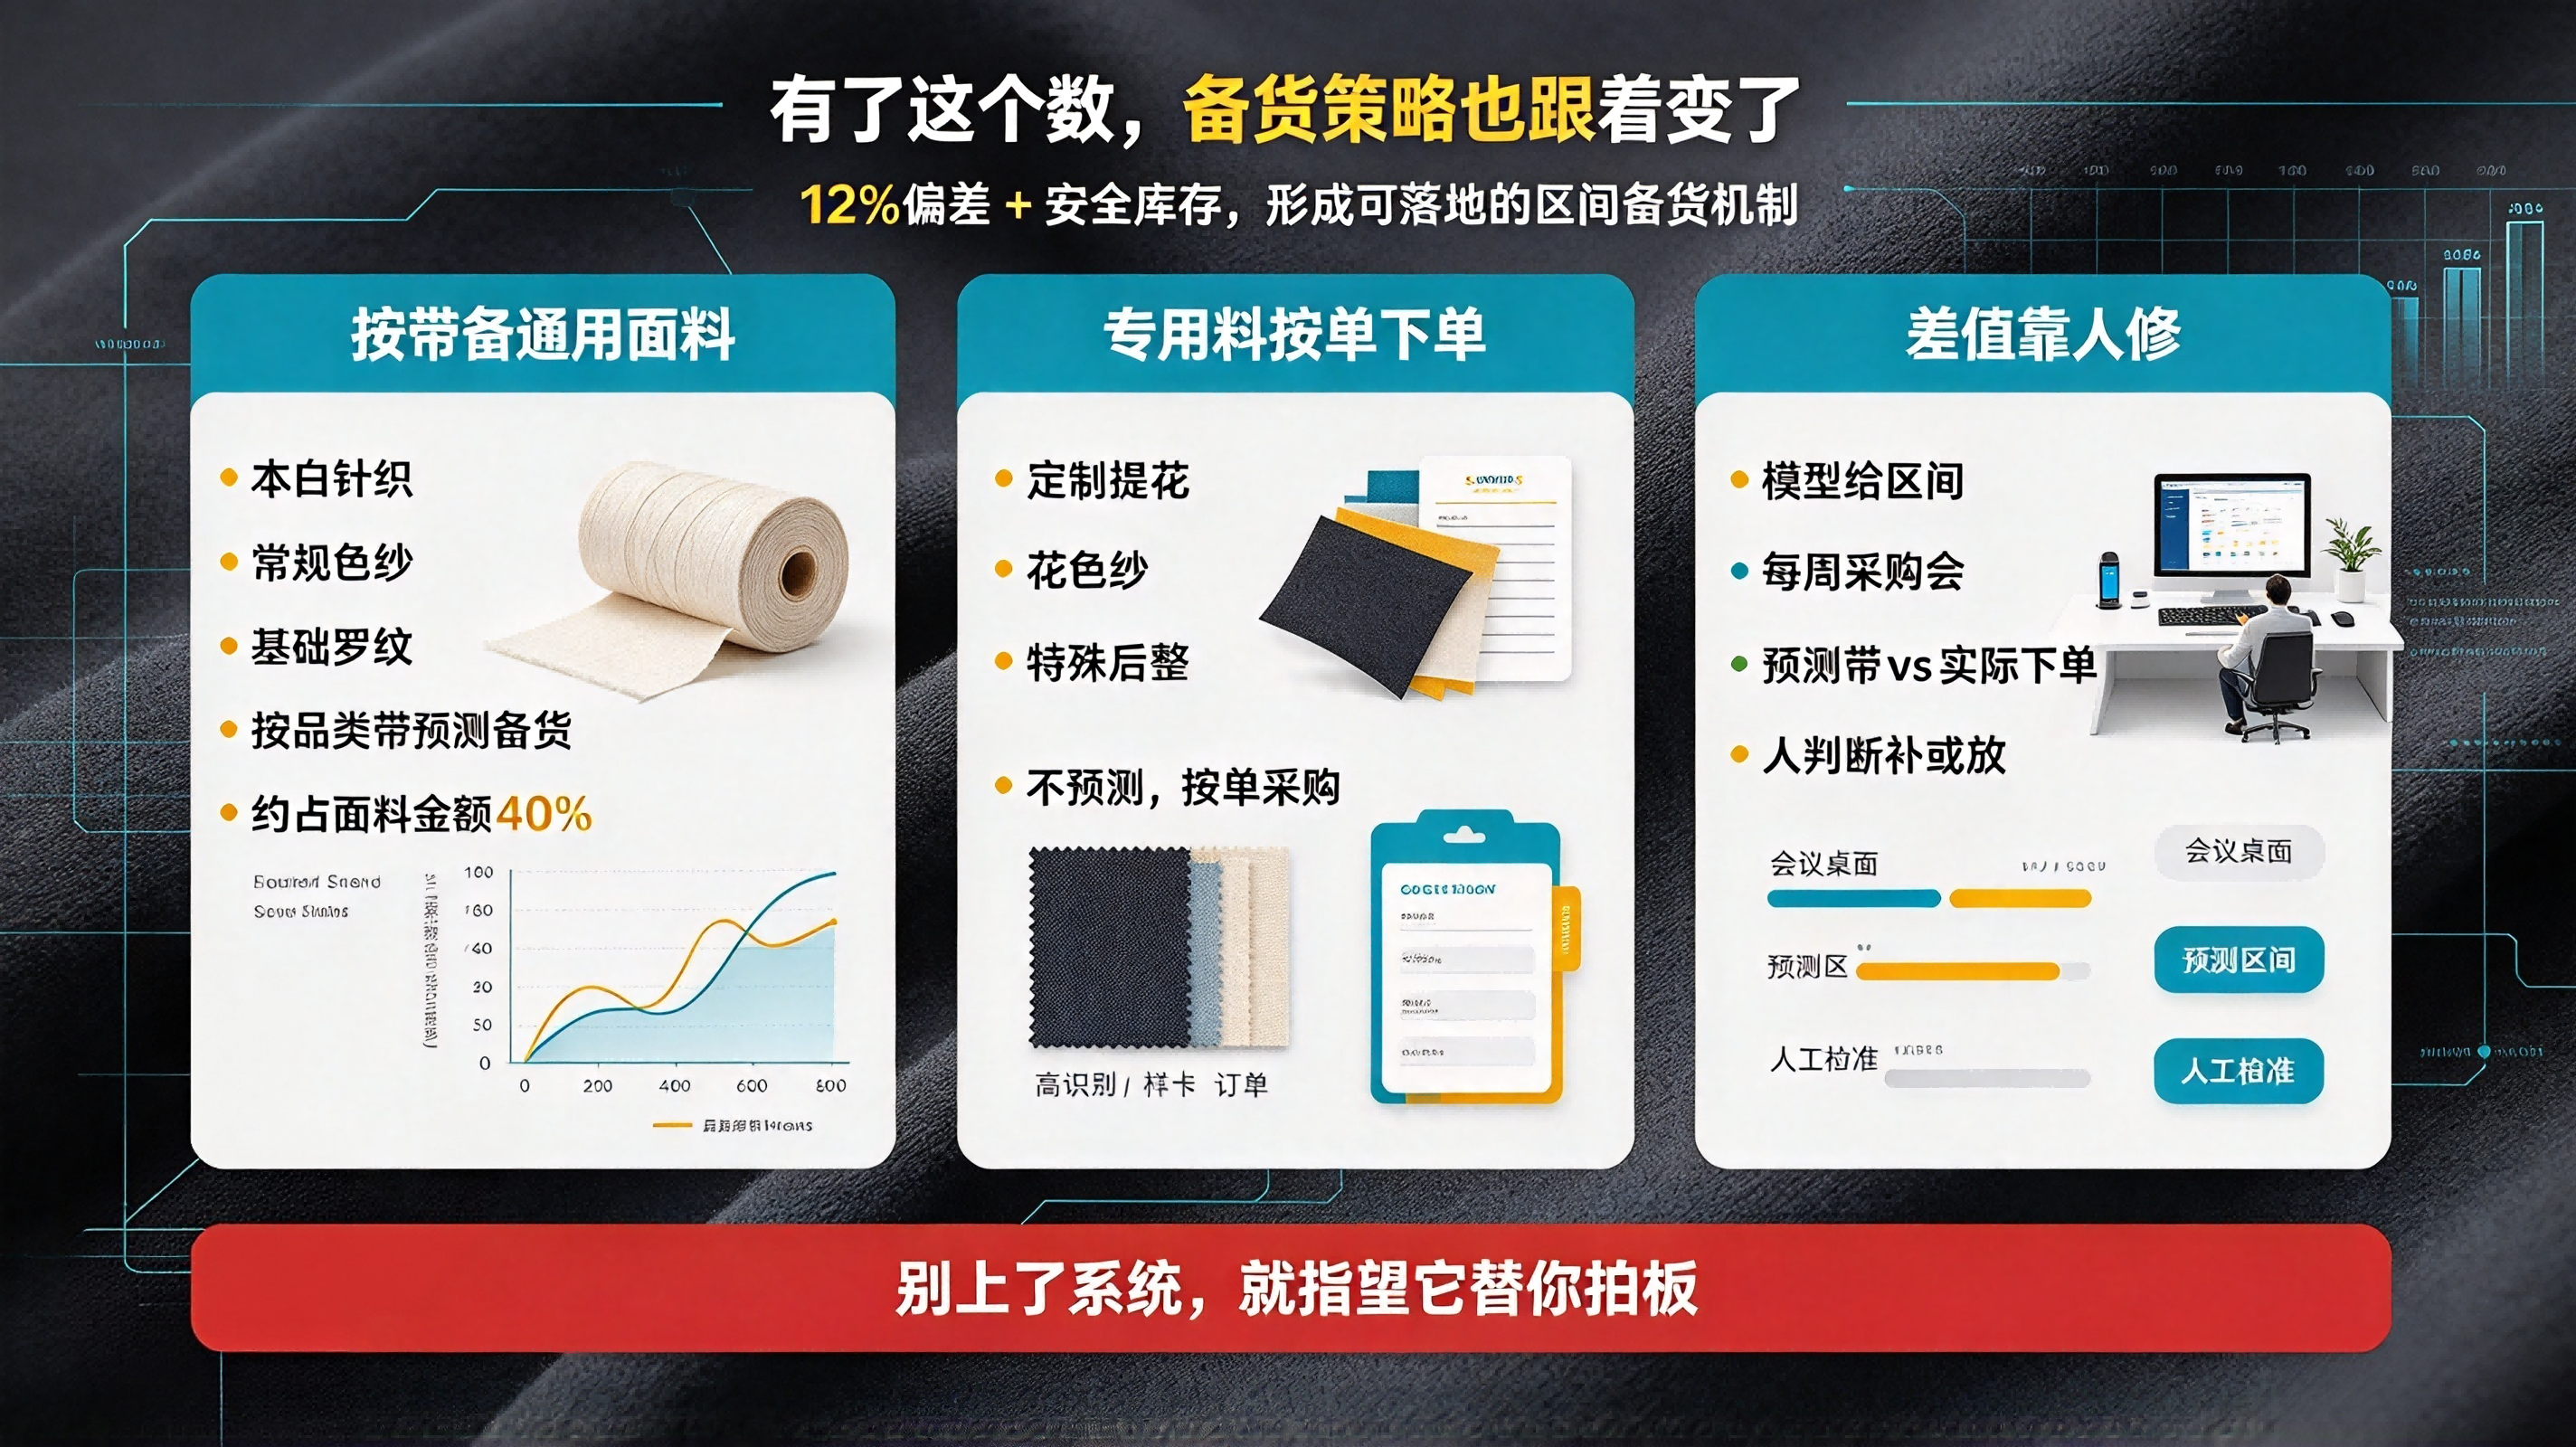
12%的偏差配上安全库存,是能用的。备货策略跟着调成三件事:按“带”备通用面料,把面料分通用料和专用料,通用料如本白针织、常规色纱、基础罗纹,按品类带预测备,占面料金额的40%;专用料如定制提花、花色纱、特殊后整,还是按单下单,不预测。差值靠人修,模型给的是区间不是答案,每周采购会开一次,看预测带和实际下单的差,差的由人判断补还是放。这一条最重要,也最容易被忽略:别上了系统,就指望它替你拍板。
八、半年后的四组数
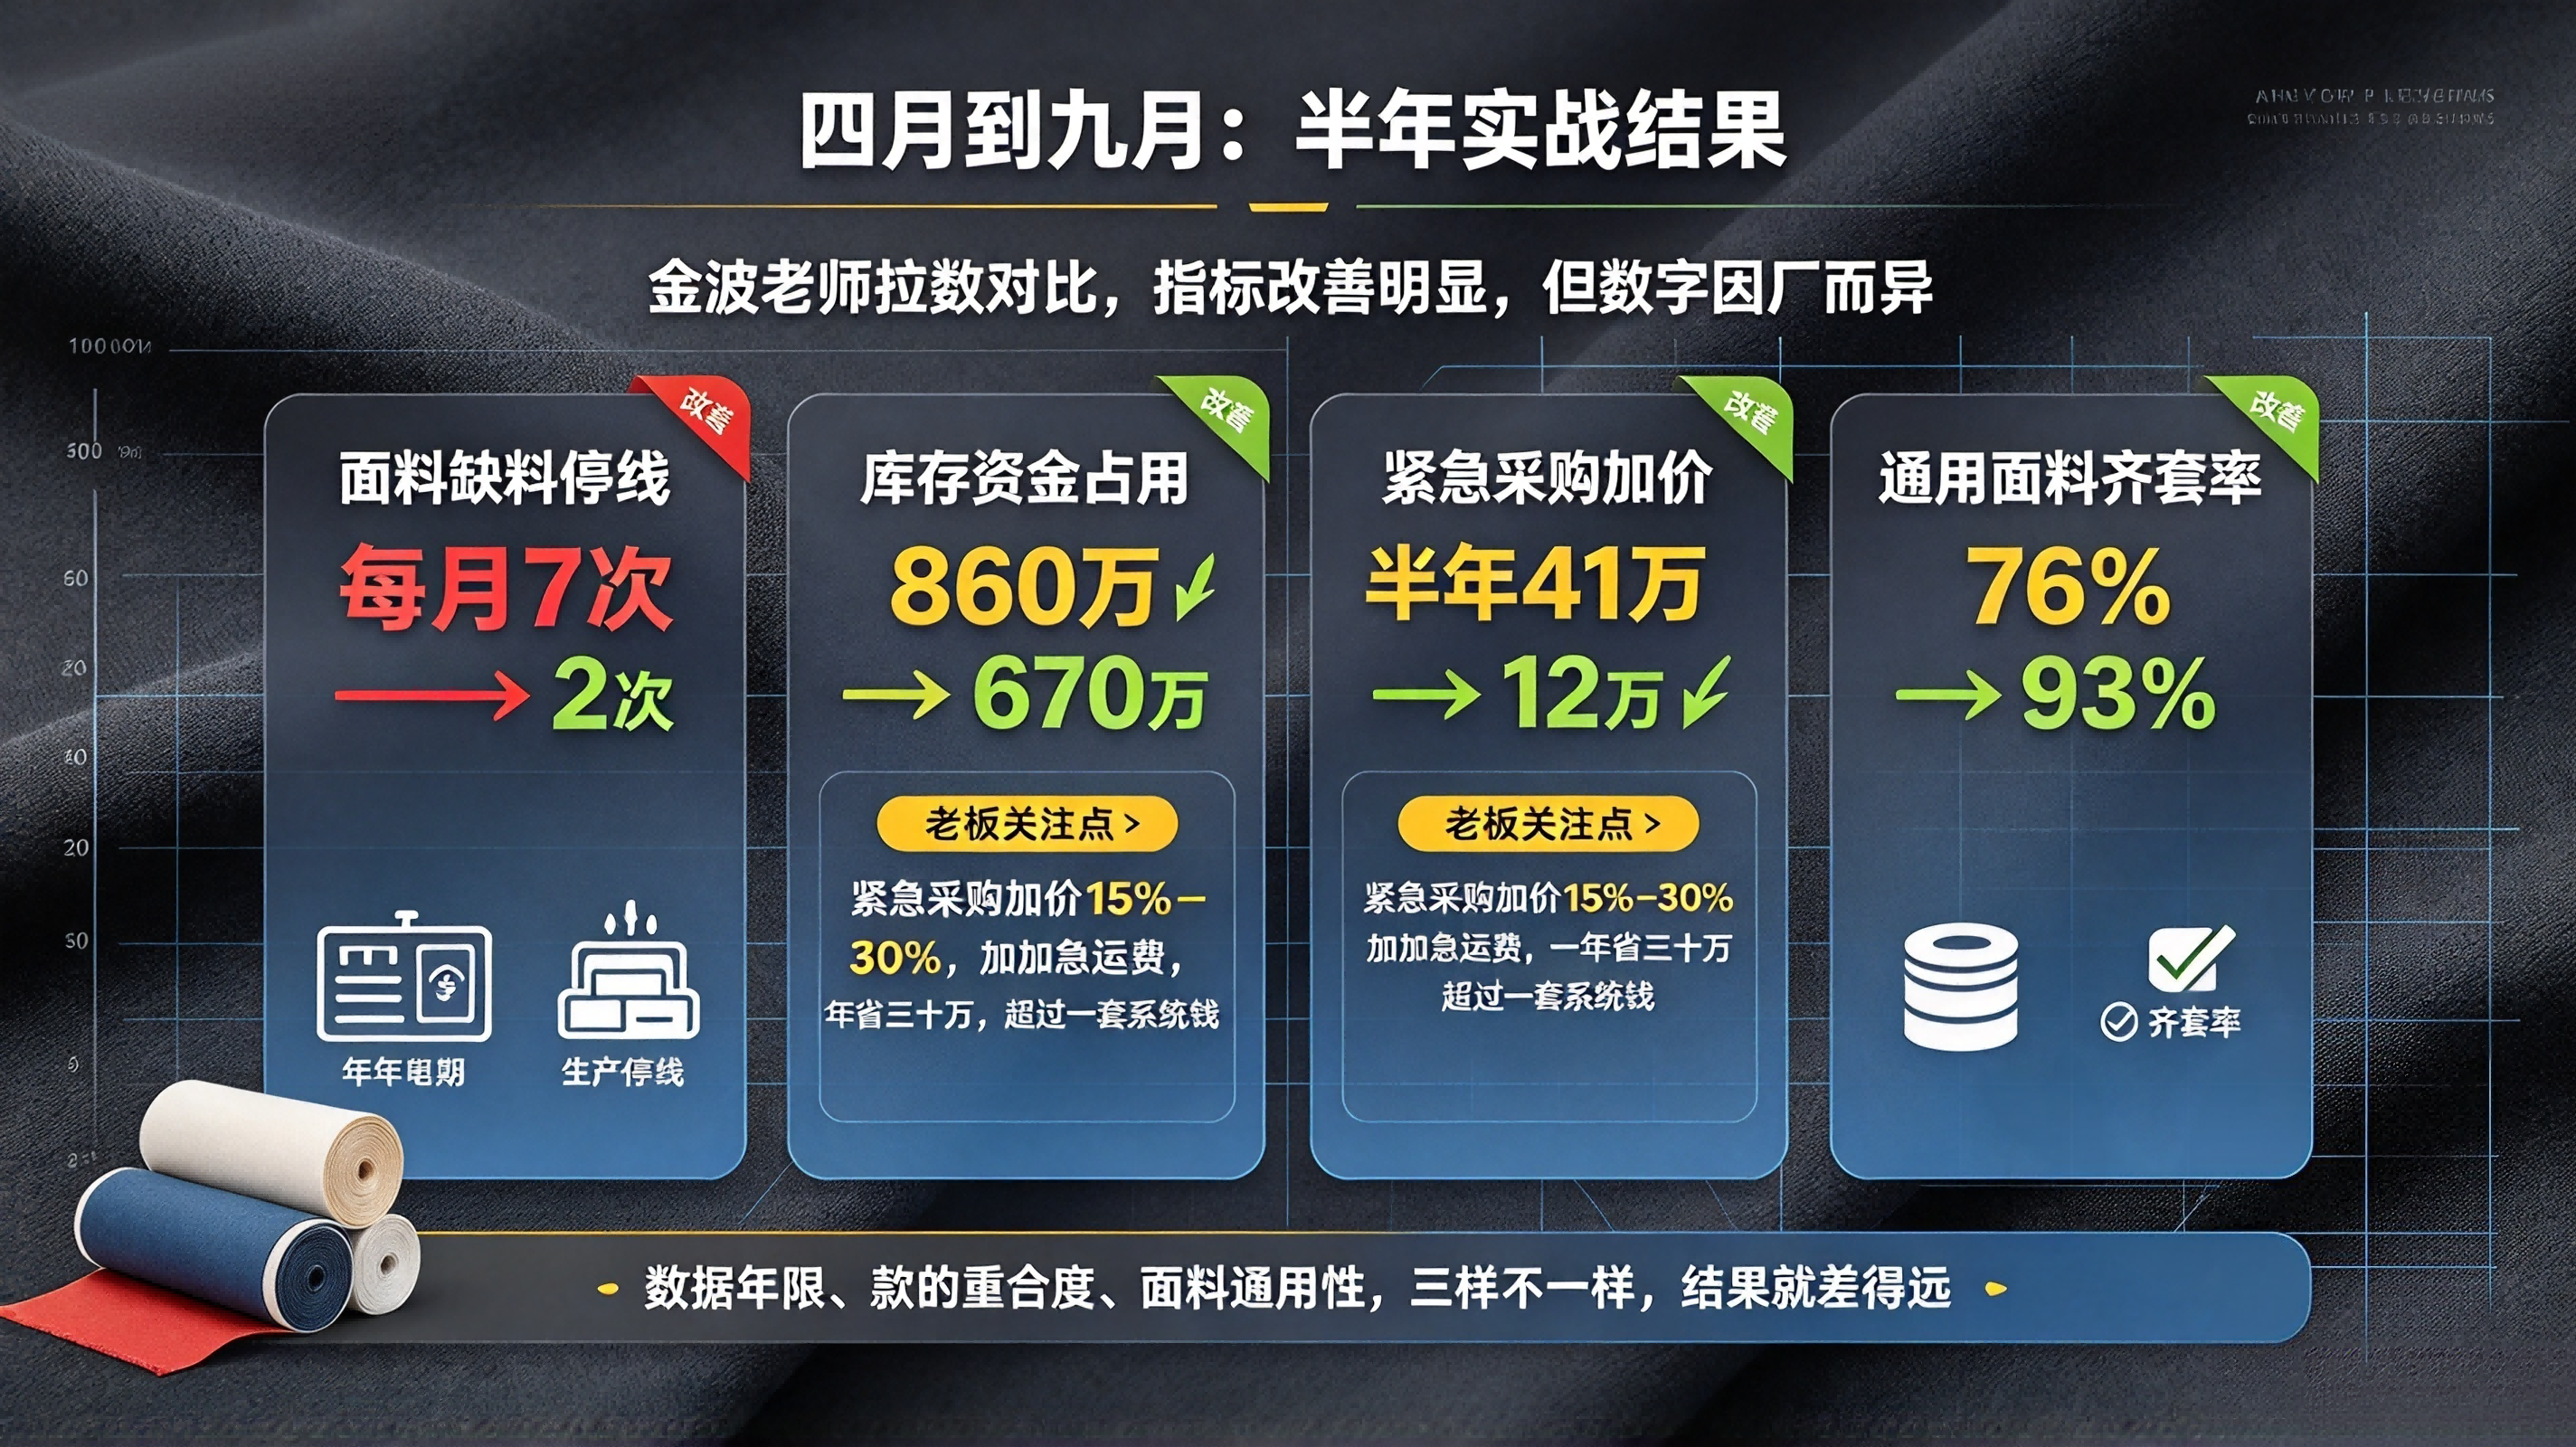
这套从四月跑到九月,金波老师上次去的时候拉了组对比,跟去年同期比:面料缺料导致停线,每月七次降到两次;库存资金占用,从860万降到670万;紧急采购加价,半年从41万降到12万;通用面料齐套率,从76%提到93%。第三组是老板最在意的,紧急采购通常加价15%到30%,还要付加急运费,一年省下这三十万,比一套系统的钱还多。当然,换一家厂数字肯定不一样,数据年限、款的重合度、面料通用性,三样不一样,结果就差得远。
九、说清楚边界,也守住底线
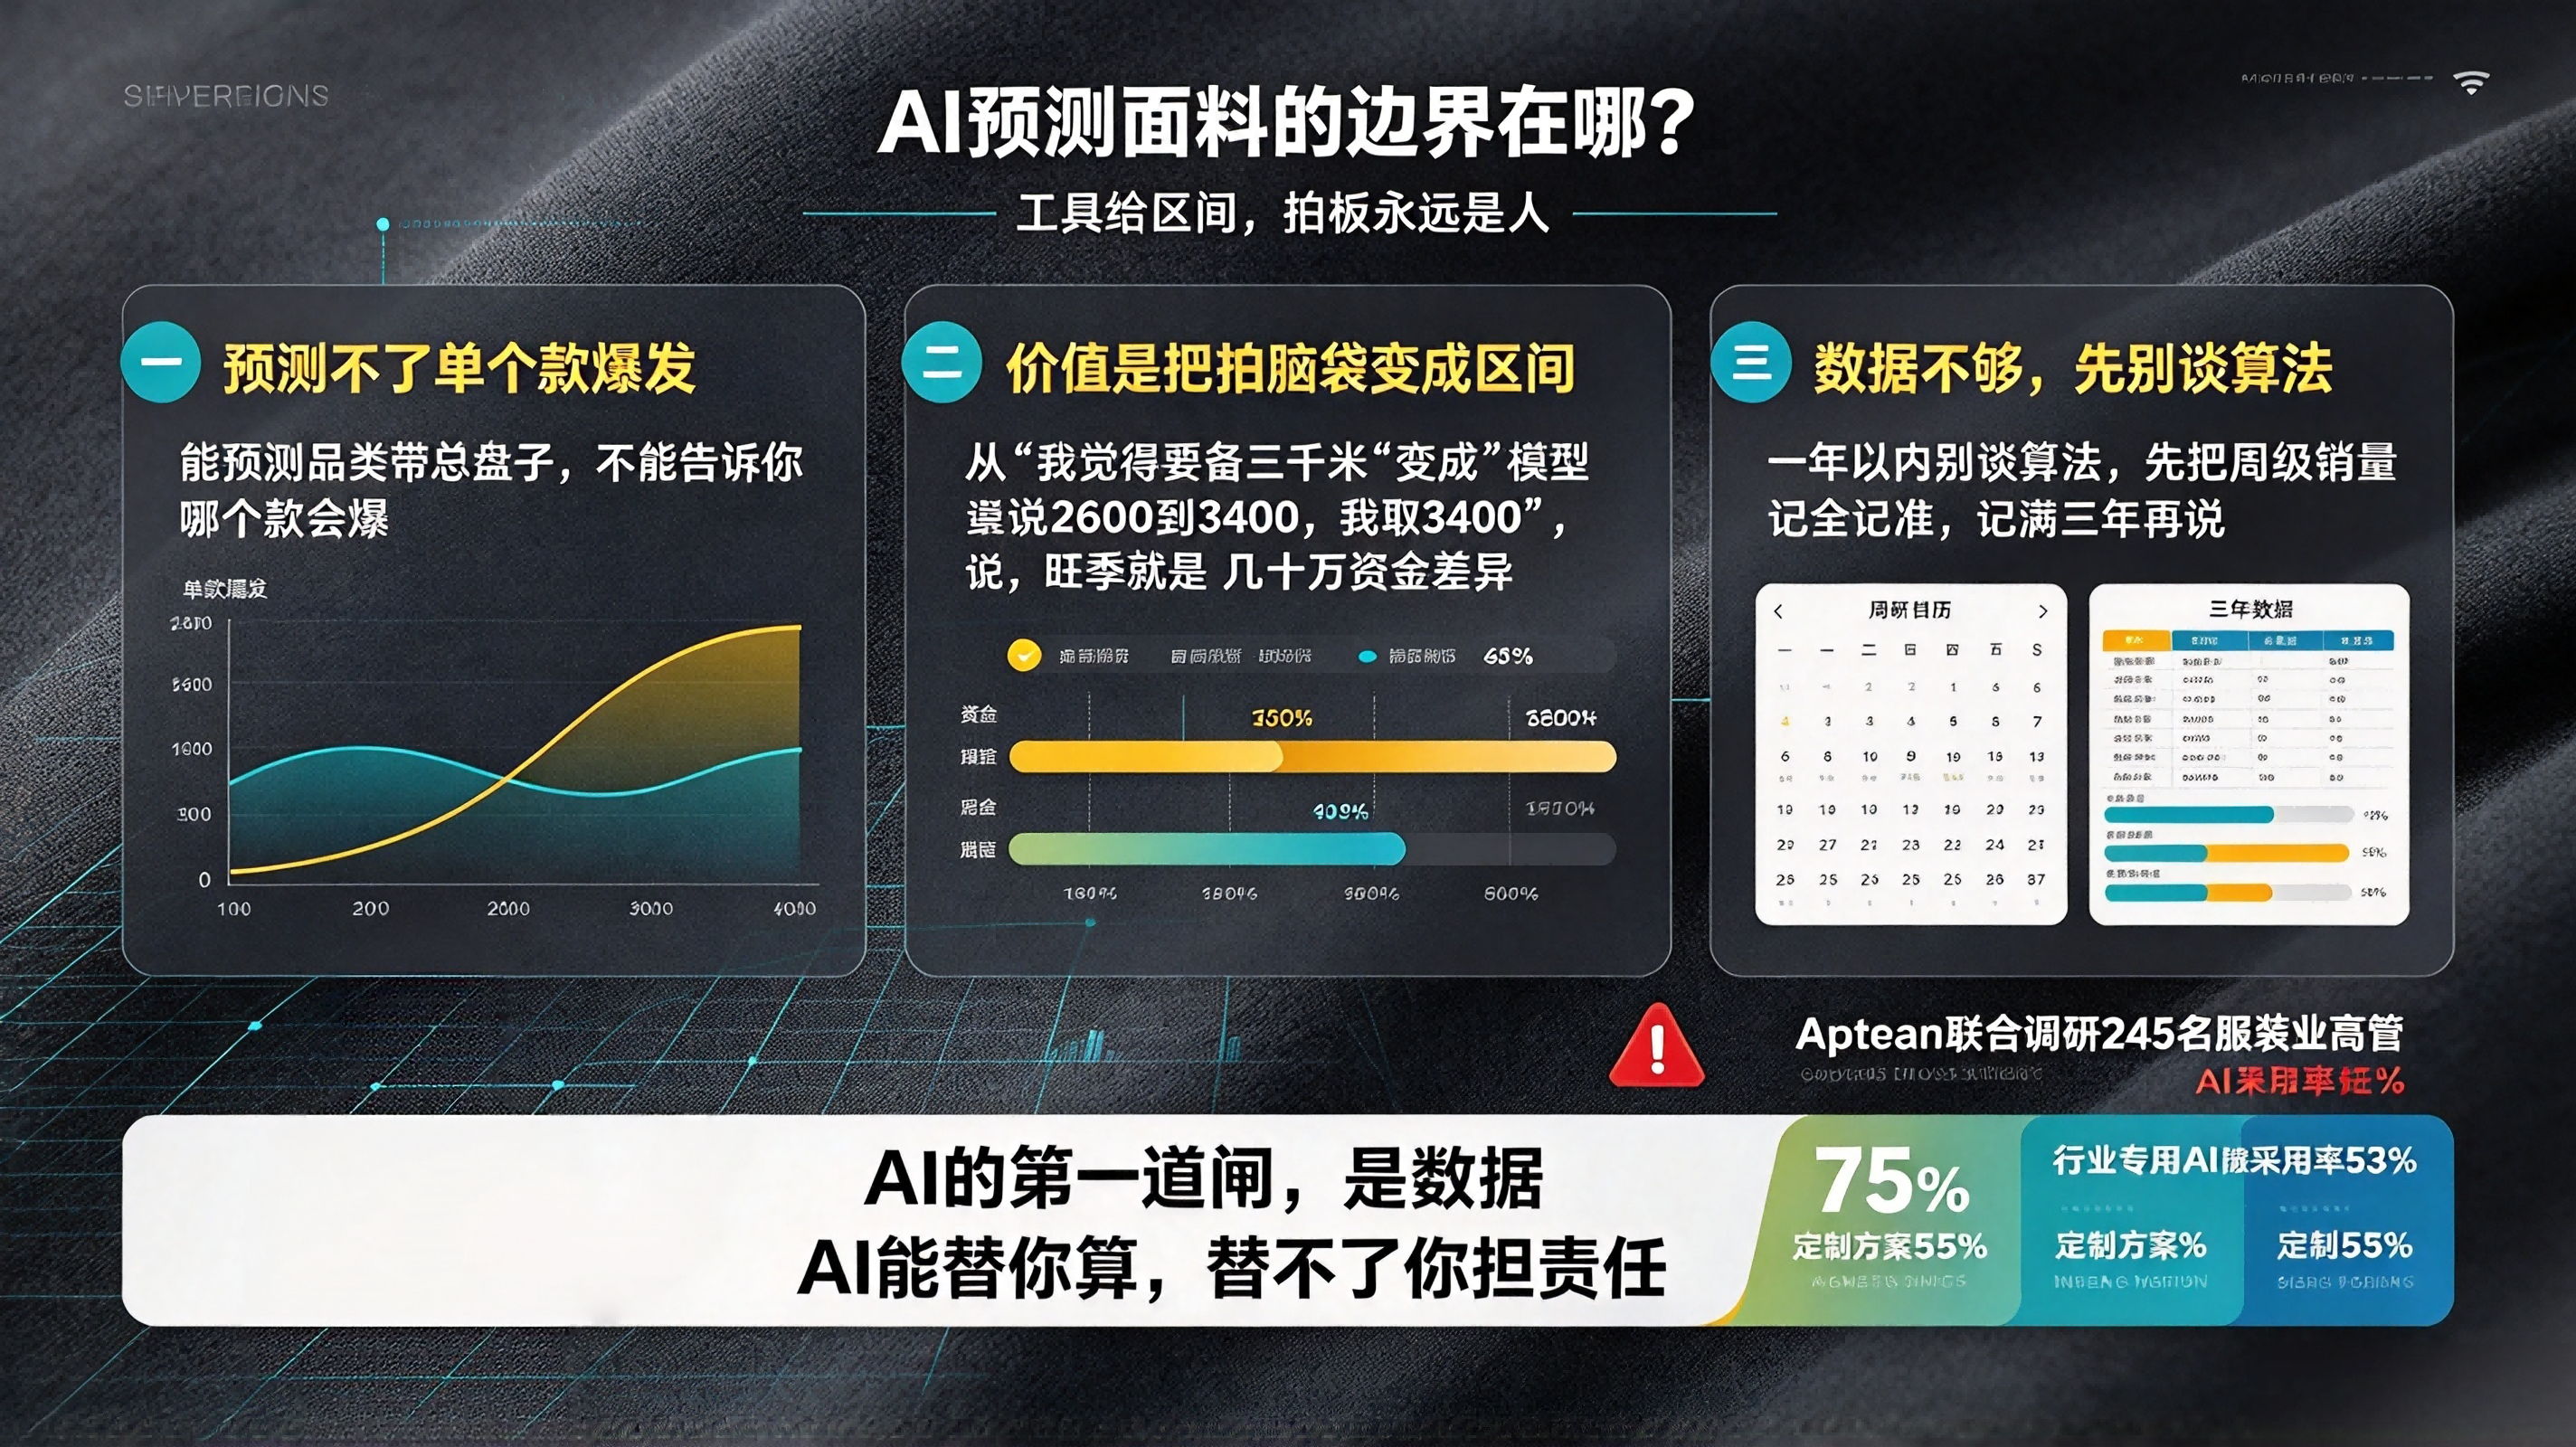
最后金波老师总结三条。一、它预测不了单个款的爆发,能预测的是品类带的总盘子,想让AI告诉你哪个款会爆,现在做不到,以后几年也够呛。二、它的价值不是算得准,是把拍脑袋变成有区间,从“我觉得要备三千米”变成“模型说2600到3400,我取3200”,这在旺季就是几十万的资金。三、数据年头不够的厂先补数据,一年以内别谈算法,先把周级销量记全记准,记满三年再说,这是最不性感、也绕不过去的一步。工具给的是区间,拍板永远是人,AI能替你算,替不了你担责任。这判断也不只是金波老师个人的感觉:九月底软件商Aptean联合调研245名服装业高管,行业专用AI采用率53%、定制方案55%,五个行业里排第一;可同一份调研里,75%的高管要求先把数据治理做扎实,才允许AI自主决策。AI的第一道闸,是数据。